有道翻译音频转文字怎么用?
发布时间:2026-08-18
打开手机上的有道翻译App后,点击主界面底部的“翻译”或“录音”图标,进入音频转文字模块,选择上传本地音频或启动实时录音,设置识别语言、降噪和分段选项,然后点击开始转写,等待识别完成即可在界面内校对、保存或一键导出文本。
有道翻译录音转写入口
本地录音文件选择
- 会议录音导入:当手头已有会议或访谈的录音文件时,可在有道翻译的音频转文字界面选择“上传文件”并从手机或云盘中导入,适用于清晰录音且需要后期校对的场景;导入时注意文件格式和时长限制,若识别中断或报错可尝试先转换为常见的MP3或WAV格式再重新上传,若仍出错可拆分音频后逐段导入继续处理。
- 课堂录音导入:教师或学生将课堂录音传入有道翻译,用于整理课堂笔记与复习提要,适合语音清晰、噪声较小的课堂环境;上传前可对长时音频进行剪辑避免超时,识别过程中如出现错词或断句,应在转写结果中手动校对并使用分段回放定位问题,再重新识别有问题的片段以提高最终文本准确率。
- 采访音频批量导入:记者或内容创作者批量导入多段采访录音进行转写时,可利用有道翻译的批量上传或压缩包导入功能,适合需要快速生成初版稿件的场景;注意每个文件命名清晰以便核对,若某些文件识别失败可能由编码或采样率问题导致,可先用音频编辑软件调整参数再重试,必要时分批次小量上传以避免网络中断影响进度。
实时录音启动入口
- 现场会议实时录制:在开会或研讨时直接使用有道翻译的实时录音功能,点击界面中的录音按钮开始收音并同步生成文字,适用于需要即时记录要点并生成会议纪要的场景;录制前应打开降噪或选择近距麦克风以提高识别率,若现场噪声较大导致识别错误,可在会后将录音下载并使用更高精度模式重跑一次来修正文本。
- 课堂实时记录:学生在课堂上开启有道翻译实时录音并边听边生成文字,用于快速获取讲课要点并方便回看与整理,适合讲师讲话语速适中、麦克风良好的环境;若发现断句或识别断层,应适时暂停分段录制或在讲义中标注时间点以便后续校对,当出现识别卡顿可以切换网络或重新启动应用继续录制。
- 现场采访即时转写:记者在街头或活动现场使用实时录音功能快速获取被采访者原话并生成初步文字稿,适用于需要快速记录并即时引用的情形;现场风噪或多人同时讲话时可能导致词句混淆,建议靠近受访者并使用定向麦克风,若转写内容不完整可随后上传高质量录音重跑识别并补充遗漏内容。
有道翻译文件导入转写
支持格式与大小检查
- 格式不兼容检测:在尝试导入音频文件用于有道翻译转写时,应先查看支持的文件格式和采样率说明,适合用户手头录音来自各种设备但需统一为常见编码时;如果上传时报错或识别结果异常,通常是格式或码率不符,可用转换工具将文件转为系统推荐的WAV或MP3并调整采样率后再导入,文件过大的情况可分段处理或压缩后重传继续工作。
- 单文件大小限制处理:当音频文件超出有道翻译单次上传大小上限时,应在本地将音频按时间轴切分为若干小段再逐一导入,适用于长时间录音如整场会议或讲座的转写需求;切分过程中要保留时间戳或段名以便拼接识别结果,若切分后仍出现识别中断,尝试更换网络或使用电脑端再上传以完成后续转写。
- 编码与采样率调整:遇到导入后识别质量低或出现乱码时,说明源文件编码或采样率可能与有道翻译默认设置不匹配,此时可用音频编辑软件将文件转换为标准采样率并重编码,适合来自专业录音设备或不同录音软件导出的音频;若转换后仍有问题,建议先试听确认原音频是否损坏,再在有道翻译中逐段上传并对比校正文本。
多语种文件识别设置
- 单一语种识别选择:当导入的音频仅包含单一语言,如整段普通话或英语演讲,建议在有道翻译中明确选择该语言以提高识别准确率,适合语言单一且发音清晰的录音;若未设置语言或选择自动检测,系统可能因背景声或口音误判,出现较多错误,遇到这种情况手动指定语言并重跑识别通常能显著提升结果质量。
- 多语种混合音频处理:对于含有中英混合或其他多语种交替的音频,先在有道翻译中选择“多语种自动识别”或按段落手动指定不同语言,适用于采访、国际会议等场景;在识别过程中如发现某段语言被误判,应标注时间段并单独上传该段指定正确语言再次识别,以避免整体转写质量下降并最终合并各段文本。
- 方言与口音校正:当音频中包含方言或强烈口音,直接使用默认识别可能产生较多词错,此时在有道翻译中选择接近的方言模型或开启容错模式更为适合,适合地域性较强的录音;若系统仍不能准确识别,需人工校对并在结果中添加音标或注释,再保存修订稿或将该片段导出供编辑使用。
有道翻译实时语音识别
麦克风与录音环境优化
- 靠近麦克风录音:在使用有道翻译实时识别功能时,应尽量靠近麦克风并面向收音源,这种做法适用于单人陈述或问答式录音,可明显提升语音清晰度和识别正确率;如果现场有回声或背景噪声,尝试切换到耳机麦克风或启用软件降噪功能,识别异常时应先检查麦克风权限与音量设置再重启录制流程。
- 选择安静环境录制:进行实时识别前尽可能选择安静环境或临时靠近说话者进行录音,适合讲座、采访或语音备忘等场景,这样可减少环境噪声对转写的干扰;如果无法避免嘈杂环境,可在识别后使用有道翻译的分段与回放功能逐段校对,必要时把关键片段单独导出并在更安静的环境中重跑识别以提高文本质量。
- 使用外接麦克风提升效果:在需要高准确率的场合,如录制播客或专业采访时,使用外接定向麦克风配合有道翻译实时识别能显著降低噪声影响并提升识别精度,适用于多人访谈或现场报道等场景;如果外接设备连接失败或识别异常,检查系统权限与接口并在设置中切换输入源,再重新开始识别流程以继续生成文本。
识别精度与模型选择
- 选择高精度模式:当需要较高准确率的转写结果时,在有道翻译中将识别模式切换到高精度或专家级模型,这适合重要会议记录或法律类访谈的转写需求;高精度模式可能会消耗更多时间与流量,如果识别速度成为问题,可以先生成普通模式草稿再对关键段落使用高精度重跑以兼顾效率与质量。
- 专业术语模型应用:在医学、法律或技术类音频中,启用有道翻译的专业术语识别模型可以提高专有名词的准确率,适用于需要保真术语或后续专业校对的场景;若系统仍错误识别特定术语,建议在转写后手动批注并导出术语表供下一次识别时上传或作为自定义词库使用,遇到模型不支持的生僻词则需人工校正。
- 方言模型与口音适配:面对方言或明显口音的录音,可以在有道翻译中尝试切换到相应的方言模型或开启口音适配功能,这在区域性采访或方言节目转写中特别有用;如果识别结果仍有大量错词,先将有问题的片段标注时间点并重新上传以指定更合适的模型,或者在文本中手动修正并保存为修订稿。
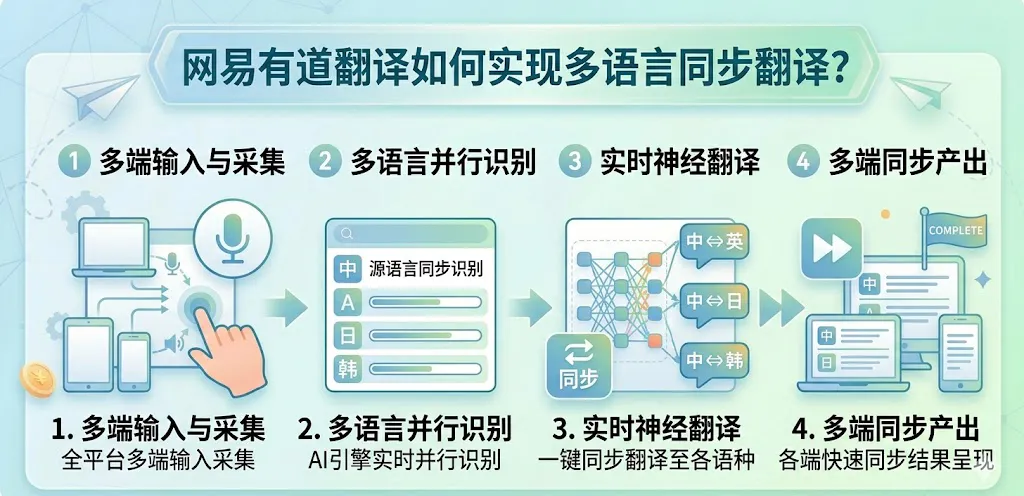
有道翻译识别精度优化
降噪与声音清理操作
- 开启软件降噪功能:在有道翻译的音频转写界面启用降噪或回声抑制选项可以在嘈杂环境下提升识别准确度,适用于街头采访、会议室或教室等存在背景噪声的录音;若降噪后仍有词错,考虑先使用第三方音频工具对原文件做轻度滤噪再上传,遇到噪声类型特殊时可分段处理并在每段中单独调节降噪强度以获得更好的识别效果。
- 手动剪辑去除空白:将长录音中明显的空白片段或与目标无关的噪音段落手动剪掉后再在有道翻译中转写,适合长时录音如讲座或研讨会的逐段处理;剪辑时要保留时间轴以便拼接识别结果,若剪辑导致语句断裂影响理解,可在编辑器中合并相邻转写文本并人工调整断句和标点以恢复语义连贯。
- 提升录音采样质量:若原始录音采样率低或出现压缩伪影,先在本地将音频转换为更高采样率或无损格式再上传有道翻译进行识别,适合从低端设备或网络录音中提取高质量文本的需求;转换后仍然识别不佳时,请检查原始录音是否因麦克风损坏或远距离收音导致不可恢复的音质问题,此类情况下需重新录制或结合人工校对来完善最终稿件。
自定义词库与术语添加
- 上传术语清单:在准备转写含大量专有名词的音频前,将常用术语或姓名列表上传到有道翻译的自定义词库,以便识别时优先匹配这些词汇,适合行业会议或产品发布会的场景;如果识别后仍出现术语错误,应在转写结果中记录错词并将其加入词库后对相关片段重跑识别,从而逐步提升特定领域的识别准确度。
- 添加人名与地名优先级:为提高对人名、地名和机构名的识别率,可在有道翻译词库中标注这些词条并设置优先级,适用于采访、新闻稿或法律材料的转写需求;如果系统仍将这些词替换为相似常用词,应手动修正一次并保存为自定义样本,后续遇到相同名称时系统会逐步学习并改进识别结果。
- 训练专属识别模型:对于经常处理同类术语或口音的团队,可在有道翻译中使用自定义样本训练专属模型以获得更稳定的识别表现,适合媒体机构或客服团队长期使用的场景;训练过程中可能需要上传多份示例音频并人工校对标签,若训练效果不理想可继续增加样本多样性或联系平台支持获取优化建议。
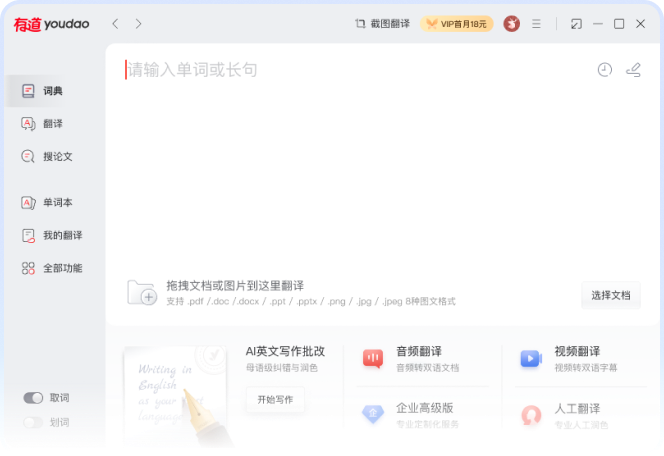
有道翻译结果导出管理
导出格式与保存选项
- 导出为文本文档:在有道翻译完成转写后,可将识别结果导出为TXT或DOCX文件以便进一步编辑和归档,适用于需要在文字处理软件中继续润色的场景;导出前应先在应用内完成一次集中校对并修正明显错词与断句,若导出过程中出现编码乱码问题,请选择UTF-8格式导出并在目标编辑器中以相同编码打开以保证文字显示正确。
- 导出带时间轴的字幕:如果需要将转写文本用于视频字幕或音频索引,可在有道翻译中选择带时间轴的导出选项生成SRT或VTT文件,适合需要精确时间定位的后期制作场景;导出后务必在播放器或字幕编辑器中预览时间同步情况,如发现偏移可以调整时间轴或重新生成分段以确保字幕与音频严格对齐。
- 一键分享到云端或邮箱:对于协作编辑或远程审核,将转写结果通过有道翻译的一键分享功能发送到团队云盘、协作文档或邮箱非常方便,适合多人审核或交付稿件的工作流程;分享前先确认接收方权限和格式需求,若链接无法访问可能是权限设置问题,应在分享界面调整权限或将文件另存为可公开链接以便顺利传递。
结果校对与版本管理
- 在线校对并保存版本:在有道翻译的编辑器内对转写结果逐句校对并保存为新版本,可为后续比对提供依据,适合需要多人反复审阅的稿件;校对时注意记录每次修改的理由并使用清晰的版本命名,以便出现识别争议或错误时回溯到原始音频并选择相应版本进行重跑或人工修订。
- 标注不确定片段:对识别中语义含糊或听不清的片段在文本中打上标注并记录时间戳,适用于复杂采访或多方讨论的转写工作;标注后可将这些片段单独导出或在会议录音中回放求证来源说话内容,必要时邀请原音参与者复核并在核实后更新文本以保证最终稿件准确无误。
- 合并多段识别结果:当音频被拆分成多段分别转写后,需要将各段结果合并为完整稿件并校对衔接处,适合长时录音的集中整理工作;合并时注意统一标点、段落和命名规则,若合并后出现语句重复或遗漏,回到相应音频片段重新识别并手动调整文本以恢复连贯性和完整性。
如何用有道翻译将音频转文字?
可以,直接在有道翻译应用中打开录音或导入音频即可转换为文字。注意选择清晰音源并在安静环境录制,手动校对并设置识别语言。
有道翻译怎样识别音频并转写?
有道翻译会使用内置语音识别引擎自动识别并转写音频。为提高识别率,请上传清晰录音、选择正确语言并检查识别设置,必要时分段处理长音频。
有道翻译音频转文字的准确率如何提高?
可以通过优化录音和调整设置来提高有道翻译的转写准确率。原因在于识别受噪音、口音和语种影响,建议使用高清麦克风、分段上传并手动校对导出结果。